解剖层 · 第 9 / 25 课
位置编码:词序从哪来
学完这课你能
- 理解注意力本身「看不见顺序」:打乱 token 集合,无位置编码的注意力输出不变。
- 理解 RoPE 的核心操作:把 Q/K 按位置旋转角度,内积只依赖相对位置差。
- 知道位置编码谱系:学习式绝对(GPT-2)→ 正弦(原版)→ RoPE(pythia / Llama / Qwen)。
先想一只钟:同一根指针,走到第几格,就从 12 点起转多大的角。RoPE 对词向量干的就是这件事——位置越靠后,转得越多。
01打乱句子会怎样
先别急着往下读,做个思想实验:把「猫追狗」打乱成「狗追猫」,模型能察觉吗?——如果没有任何位置信息,不能。注意力的全部动作是「拿 query 和所有 key 对暗号再加权求和」,这套运算里每个 token 都是平等的集合成员:整句打乱后,每个 token 的输出只是跟着换个位置,内容一模一样。词序没了,「谁追谁」这种全靠顺序的语义自然抓瞎。
第 4 课挖的坑,在这里填上:上下文窗口存在的原因之一,就是模型必须靠位置编号知道「谁在前谁在后」。位置信息得有个来源——位置编码。它从哪来?接着看。
02谱系速览
三代方案,你只要记住各自的脾气。学习式绝对位置:给每个位置学一张向量,加在输入上——GPT-2 用它,简单可靠,但训练时没见过的位置就没有向量,外推差。正弦位置编码:原版 Transformer 用固定三角函数生成位置向量,不再依赖训练,但与现代做法的配合一般。
那当前主流是谁?第三代 RoPE(旋转位置编码):pythia、Llama、Qwen 全在用。它的思路不是「加位置」,而是「转角度」。转个角度,怎么就带上了位置?往下看。
03RoPE 直觉
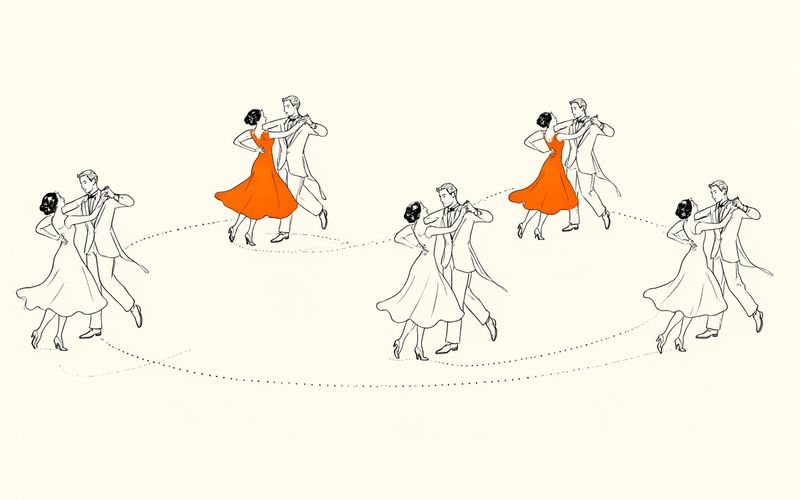
把一对维度当成二维平面上的一个点。位置 i 的向量,就把它在平面上旋转 i·θ 的角度——位置越靠后,转得越多。妙处在内积的几何性质:两个旋转后的向量做内积,结果只取决于它们的夹角之差,也就是 i−j。这张图你盯着看十秒。
「绝对位置进、相对位置出」——我们按绝对位置旋转 Q 和 K,但注意力打分(内积)天然只看见相对距离:第 5 个词看第 3 个词,和第 105 个词看第 103 个词,打分机制完全相同。这对语言是极其合理的性质:你想,「的」后面接什么,本该只跟距离有关,跟它在句子里排第几无关。舞池里成对旋转的舞者正是这样:各自转了多少圈不重要,两人面对面的夹角才重要。
04pythia 的 RoPE
来对个账。pythia 每头 32 维,其中一部分维度(25%,与引擎实现一致)被组织成一个个二维平面,每个平面配一个不同的频率 θ:低频平面转得慢,负责远距离的粗粒度相对关系;高频平面转得快,负责近距离的精细关系。多平面叠加像什么?像多根不同周期的钟表指针,组合出任意距离的「读数」。下面的旋转盘实验里,你可以亲手拧这个频率,感受快慢平面的分工。
还有一个容易忽略的细节,很多人在这里栽跟头——就藏在下面这张卡里。
05外推与长度
RoPE 还有个你可能想不到的工程福利:训练长度之外的表现相对可救。因为它是「旋转」而不是「查表」,超出训练长度的位置无非是多转几圈;对频率做点缩放微调(或干脆微调几步),模型就能在远超训练长度的文本上工作。各家「长上下文」扩展方案的底座大多在此——第 4 课那个 2048 窗口,并不是不可逾越的天花板。
交互实验:RoPE 旋转盘 + 内积-距离曲线
引擎加载中…
① 二维旋转演示盘(零权重):横轴拖 token 位置 m、调 n 与维度对频率(低频↔高频,pythia 实配 4 个平面),看 q/k 两向量转动与夹角弧,内积 q·k=cos((m−n)θ) 只随相对距离变化;「m、n 同步 +1」现场验证相对性。② 真权重验证(确认下载后):固定 9 词例句跑 pythia 前向,选层选头看注意力热图,并按 |m−n| 分桶平均画出真实 Q/K 的「内积-相对距离」曲线(d=0 对角带 + 随距离衰减的局部结构)。
等待开始下载…
组件挂载点 · RoPE 旋转盘将在下一波接入(演示盘零权重)
组件加载失败。
降级方案:演示盘为纯几何动画,不依赖权重、任何情况下都可玩;真数据区在权重下载或加载失败时显示「加载失败,点击重试」,不白屏,图文正文不受影响。