锻造层 · 第 14 / 25 课 · 训练的手感
优化器与学习率:步子大小的学问
学完这课你能
- 说清学习率=每次沿梯度走多大步;更新公式一行:w ← w − lr × grad。
- 肉眼识别三种病态:LR 太大来回震荡甚至发散、太小磨蹭、适中收敛。
- 知道动量(momentum)的作用:攒惯性冲过小坑;以及现实中 Adam 系为什么常用。
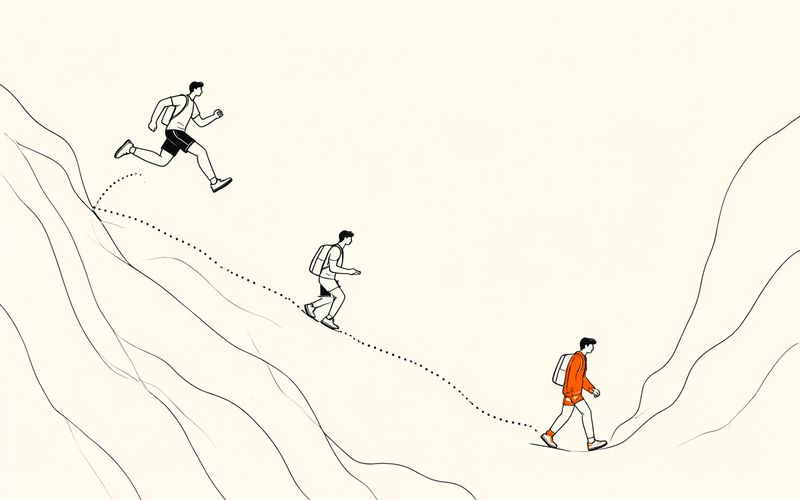
三个人蒙着眼下同一座山:第一个步子迈得太大,在谷两侧来回弹;第二个挪着小米粒,半天还在半山腰;第三个步幅匀称,稳稳往谷底去。同一张地图,命运全在步子大小。
01照账改钱
上一课说清楚了分工:反向传播只算账——它交出每颗参数的悔意清单(梯度);优化器是出纳,照账改钱。改法朴素到只有一行:
w ← w − lr × grad
每颗参数 w,沿着负梯度方向挪一小步,步长就是梯度乘以学习率(learning rate,lr)。梯度说方向和急迫感,学习率拍板步子多大——本课的主角就是它。
02步子大了会怎样
直觉说步子大走得快?山谷不吃这套。步子太大,一步跨过谷底踩到对面坡上,下一步又弹回来——过谷底而不入,来回横跳;倒霉起来越弹越高,loss 直接上天,这叫发散。步子太小,方向明明对,磨磨蹭蹭几百步还在半山腰。
03三胞胎赛跑
光说不练假把式。实验台里有三只同起点的孪生模型:同一份初始化(共享 seed)、同一份唐诗教材,唯一的差别是学习率——默认 0.01 / 0.1 / 1.0,对数刻度随便拖。一键同跑,三条 loss 曲线叠画进同一张图,谁先到底、谁来回横跳、谁磨蹭,一眼分明。训练完还能让三只各交一份作业,比比谁的诗更像诗。
04动量:给小球配惯性
更新公式还有个常配的加项:上次步子的余温。w ← w − lr × (momentum × 上次步子 + 梯度)。想象雪球下坡:哪怕滚进一处小坑,身后的惯性也能推着它碾过去继续下行——动量(momentum)攒的就是这份惯性。它在平坦段攒速度、在震荡段互相抵消,常常让收敛又稳又快。
别信文字,信实验:给某条轨道拧上动量开关再跑一轮,亲眼对比。
05现实中的 Adam
真实训练几乎不用裸 SGD:主流是 Adam 系优化器——它给每颗参数自适应调步长(梯度常来的参数步子小、少见的参数步子大),再叠加本课这两个直觉(学习率上限 + 动量惯性)。本站引擎用的是最朴素的 SGD + 动量,因为本课要让你看清水温、水深之前不加料;你在这里养成的手感——盯曲线形状辨 lr、给惯性开关——到 Adam 时代全部平移过去,一句数学都不用新增。
交互实验:三胞胎训练对比(现场真训 ×3)
引擎加载中…
三只孪生 mini-GPT(同 seed 初始化、同唐诗语料、同 batch 抽样序列)在你的浏览器里同步真训——三条曲线都是现场算出来的,无预录数字。LR 滑杆对数刻度 0.001–3.0,可边跑边拖;动量开关随时拧。默认每轮 150 步保流畅(三轨道轮转分帧,UI 不冻结)。
组件加载中…(三胞胎训练台需要 JavaScript;正文不受影响)
组件加载失败。
降级方案:自动切换「离线赛跑实录」回放(assets/data/phase2/l13-train-traj.json.gz,同一训练器在 node 真跑的六条轨迹:3 档 LR × 动量开关,seed 42)——曲线照常对比播放,角标变为「回放」。