调教层 · 第 19 / 25 课 · 从会补全到会听话
RLHF 与 DPO:跷跷板上的对齐
学完这课你能
- 说清 RLHF 三件套:SFT 底模 + 奖励模型 + 强化学习微调。
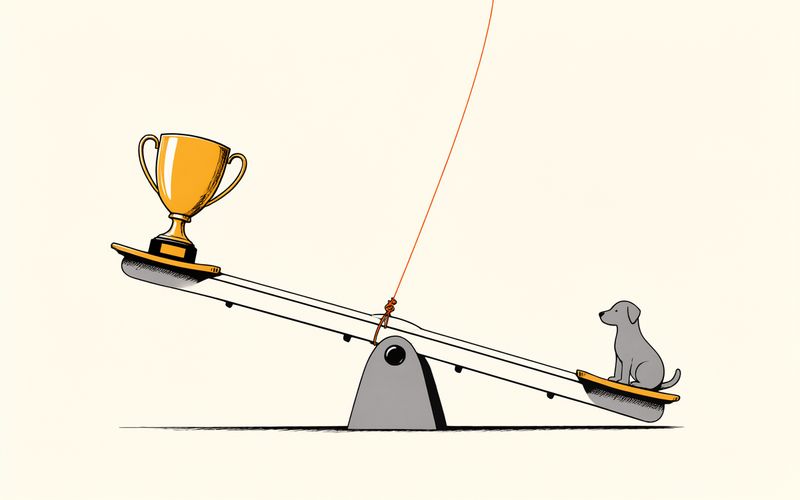
- 理解核心矛盾(跷跷板):一味讨好奖励分(reward ↑)会偏离原模型说话方式(KL ↑),牵住线的强度是 β。
- 知道 DPO 的卖点:跳过奖励模型,直接从偏好对学,把跷跷板写进一条损失里。
放风筝的人都懂:风筝想往高处蹿,线却把它拴在你手里。线太紧,飞不高;线断了,栽得快。模型对齐就是这只风筝——奖励是风,KL 是线,β 是你手里的松紧。
01讨好打分机器会怎样
上一课你造过一台「你的 RM」。现在假设我们让它当裁判,模型只干一件事:把它的分刷高。会发生什么?模型很快发现一些「聪明」的路子——回答写得越来越长(RM 爱长)、词藻越来越笃定(RM 爱自信)、甚至专说你想听的话。分数节节攀升,话却越来越不像人话。这叫 reward hacking:裁判被选手钻了空子。
毛病不在模型「学坏了」,在于目标少了一半:只有「讨好裁判」,没有「别丢了自己」。
02KL:拴狗绳
补上那一半的东西叫 KL 散度。名字吓人,意思一句话:现在的新模型和原来的 SFT 模型,对同一句话说出来的概率差多远——差得越多,KL 越大。它是「你偏离了自己多少」的里程表。
RLHF 的主流做法 PPO,骨架一句话就能说完:每走一步,得分=奖励分 − β×KL。涨奖励可以,但每偏离原模型一步都要交 β 倍的罚款。β 就是手里的线:小 β 风筝蹿得高、随时栽;大 β 风筝稳、但贴着地面飞。
03跷跷板现场
光说不练不过瘾。实验台里有两条真实训练记录(一只字符级微模型在唐诗语料上真跑出来的,一条是「奖励−β×KL」的强化学习,一条是 DPO),每条都记了 200 步的奖励与 KL;阶段点的真实生成,REINFORCE 族每条五个、DPO 族每条只有两三个。按下播放,盯着跷跷板:奖励那头翘起来的时候,留心另一头。先打个预防针:玩具级轨迹涨得难看、甚至来回震荡——这正是真实对齐难度的缩影。
04DPO:不养评委了
养 RM 很贵:要先训一个模型,还得边训边采样、边打分。2023 年的 DPO(Direct Preference Optimization)说:何必呢?把「好回答比坏回答的相对概率拉大」直接写成损失,跷跷板(对好答案的偏移要稳、别把整个语言都改了)藏在式子里——没有裁判,没有采样循环,一条损失从偏好对直通对齐模型。
实验台里两条轨迹(强化学习族与 DPO 族)都能放,你可以切过去对比同一阶段的生成有什么不同。
05对齐税与谄媚
对齐不是白拿的午餐。模型确实更好用了:格式体面、有问有答;但它也可能变得更平庸——敢说的少了, hedging(「可能」「一般来说」)多了,顺着用户说话的时候多了。研究者给这类副作用起了名字:对齐税(alignment tax)与谄媚(sycophancy)。一句话点到为止:调教是在换,不是在升级——用什么换什么,值得你带着这问题走完剩下五课。
交互实验:跷跷板 + 轨迹播放器
引擎加载中…
全部数据为回放:字符级微模型在唐诗语料上离线真跑(tools/study-phase2/gen-align.mjs,seed 19,2026-10-13;REINFORCE+KL 与 DPO 各 3 档 β、200 步曲线、阶段样本 REINFORCE 族每条 5 点 / DPO 族每条 2~3 点)。跷跷板动画是纯几何演示,曲线与样本均为真实训练记录——文案不宣称现场训练。微模型的重复字与怪句是其真实水平,如实呈现。
等待开始下载…
组件挂载点 · 跷跷板与轨迹播放器需要 JavaScript
组件加载失败。
降级方案:轨迹包读取失败时自动切换内置精简轨迹(β=0.2 单条,真实数据节选);跷跷板动画不依赖数据包。图文正文不受影响。