发力层 · 第 22 / 25 课 · 把模型跑起来
KV cache:为什么要记笔记
学完这课你能
- 说清朴素自回归的浪费:每生成一个 token,前文所有 token 的 K、V 都被重算一遍。
- 理解 KV cache:把每层的 K、V 存成笔记,新 token 只算自己那一列。
- 会看两条曲线:无 cache 的实测耗时怎么随长度爬坡,cache 的解析线为什么平。
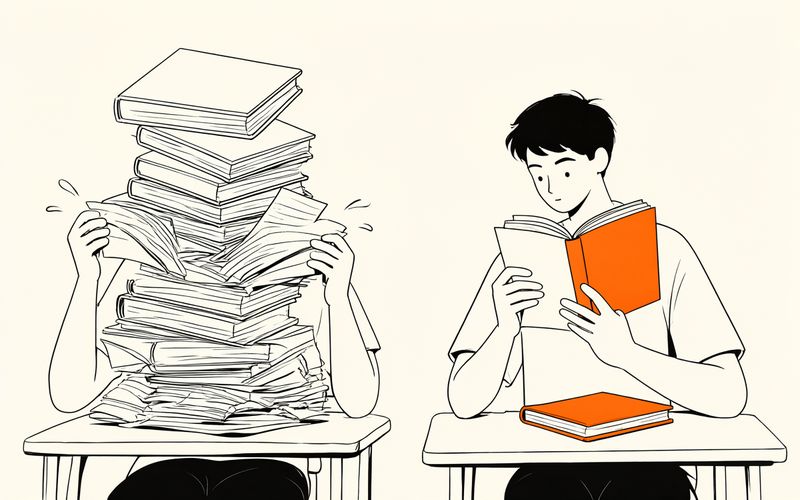
两个学生读同一本书:左边那位每翻到新的一页,都从头把整本再读一遍,读得满头大汗;右边那位边读边记笔记,翻到新页只看新的一页。你的浏览器里那台 14M 小模型——第 3 课到今天——一直是左边那位。
01重复劳动的账
第 3 课说过一句话:「引擎每次拿到完整序列,都从头算一遍」。当时你感知不到,因为 20 个 token 的前向也就几十毫秒。现在把账摊开:生成 64 个 token,第 1 步算 1 列,第 2 步算 2 列……第 64 步算 64 列——总共 1+2+…+64 = 2080 列。而理论上「真正新」的信息只有 64 列。97% 的算力,花在了重读旧书上。
为什么是「列」?注意力里每个 token 对前文做的事,是拿自己的 Q 去查所有人的 K、再搬回所有人的 V。第 n 步时,前 n−1 个 token 的 K 和 V 跟上一步一模一样——它们只取决于各自之前的上文,新 token 根本影响不了它们。重算它们,纯属把同一页书再读一遍。
02笔记记什么
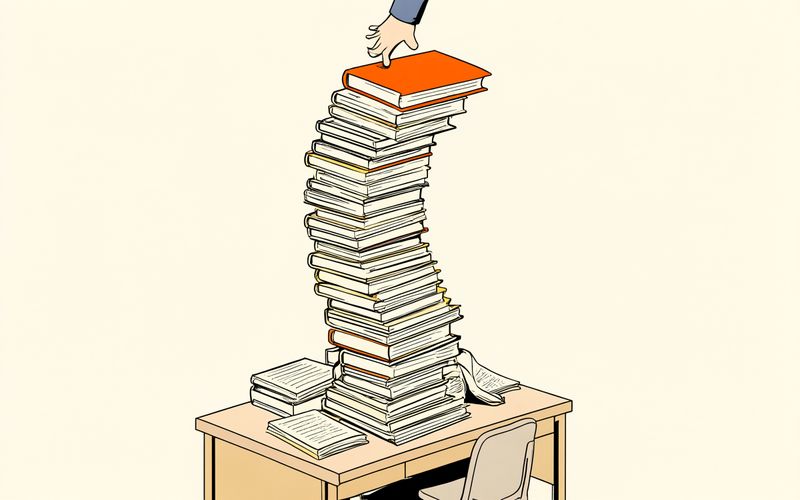
谜底就在第 5 课的名字里:K 和 V。这两个张量本来就是「上文每个 token 留给后来者的便签」——K 是招牌(我这里有什么),V 是货(我能提供什么)。它们一旦生成就不再变化,天然适合存下来复用。这就是 KV cache:每层把算过的 K、V 存进显存,下一步只算新 token 自己那一列,旧的直接查笔记。
03真测:越读越慢
下面的实验台对真模型现场计时:长度从 4 到 64 逐档真跑前向,每档跑 3 次取中位数(单次计时抖动大,中位数稳)。你会看到一条往上爬的实测曲线——每一步都比上一步更贵,这就是「重读全书」的疼痛曲线。诚实声明:本站引擎没有实现 cache(教学上有意让你看清两种模式的差距),所以实验台测的是无 cache 这一条线,明明白白。
04对照:记了笔记之后
实测曲线旁边可以叠一条 cache 的对照线。先说清楚口径:那条线是解析计算不是实测——按「无 cache 第 n 步 ∝ n 列、有 cache ∝ 1 列」的比例,用 pythia 真实 config 算出相对工作量,锚定在实测首点上。图上「实测」「解析」两种口径分标,不许冒充。两条线的岔口越拉越开,那个开口就是 cache 的价值。
笔记本身多占地?实验台第二块账本现场算:KV 字节数 = 2(K 和 V)× 6 层 × 每列 128 维 × 2 字节(fp16)× 长度。64 个 token 的笔记约 192KB——听着不大,乘到 2048 窗口、再乘到 7B 模型的 32 层 × 4096 维,就是 GB 级的地皮。这正是第 23 课「给模型瘦身」要接的盘。
05长上下文为什么贵
把镜头拉远:你交给大模型一段万字的 prompt,第一件事不是「生成」,而是把这一万字整体吃进去一遍(术语叫 prefill)——这一次性账单按长度计价。之后每个输出 token 一笔小账。下一课(最后一课!)把 prefill、decode、cache、量化拼成完整推理栈,给整门课收口。
交互实验:耗时真测台 + KV 显存账
引擎加载中…
长度滑杆(8–64)+「开测」:每档长度真跑 pythia 前向 3 次取中位(实测);「叠加 cache 对照」画解析比例线(解析,本引擎无 cache,不假装测它);「算 KV 显存账」现场算笔记占地。真权重、真计时,全部在你的浏览器里。
等待开始下载…
组件加载中…(耗时真测台需要 JavaScript)
组件加载失败。
处理方式:多为网络抖动或权重文件缺失——刷新页面,或看下方「参考机实测曲线」的回放版,图文正文不受影响。